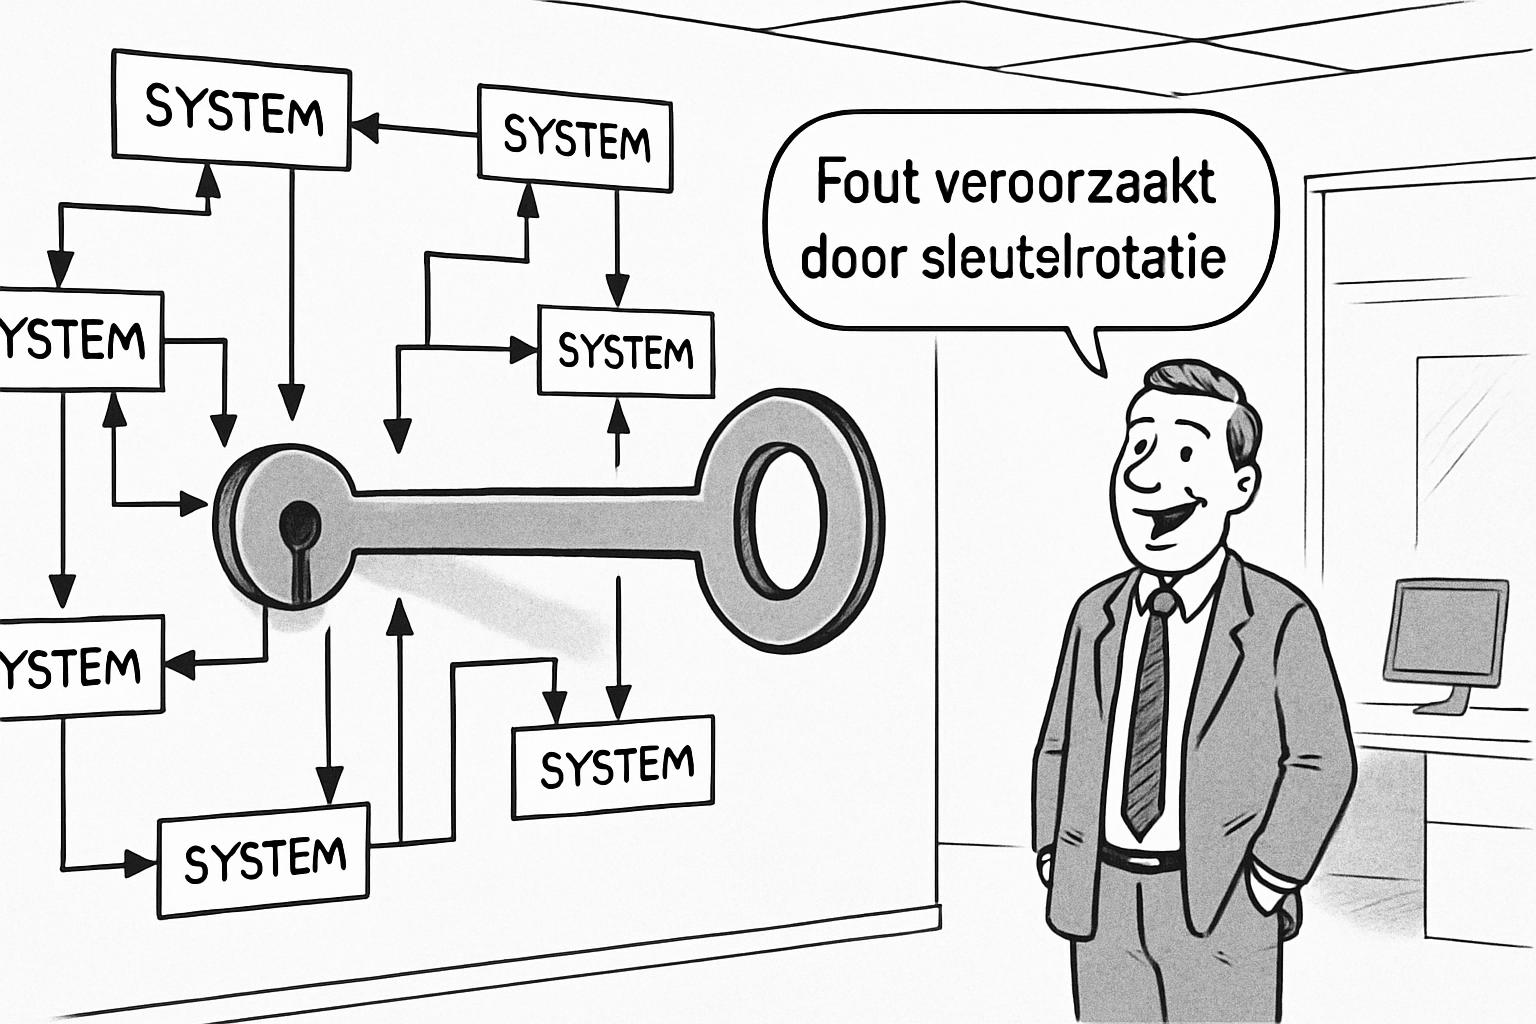
Het is vrijdagmiddag als de servicedesk een stroom tickets krijgt: accounts die niet inloggen, batches die blijven hangen en een callcenter dat geen klantgegevens meer ziet. Niemand heeft een firewall alarm, er is geen malware-signaal en de monitoring rapporteert groene lampjes. Wat er tóch gebeurde: één kleine wijziging in de authenticatieconfiguratie van een externe identiteitsprovider brak de keten waarop tientallen interne processen vertrouwden.
Dat is geen anekdote. Het is een patroon. De grootste cyberafhankelijkheid van organisaties staat zelden in het risicoregister omdat het geen asset is, geen server en soms niet eens een leverancier: het is een samenstel van vertrouwen, processen en ongedocumenteerde kennis. Mijn stelling is helder: risicoanalyse die alleen op zichtbare assets en dreigingen focust, mist de cruciale systeemafhankelijkheden die je organisatie bij de eerste echte storing platleggen.
Je risicoregister kan vol staan met geformaliseerde dreigingen, maar als niemand eigenaar is van de integratielaag tussen systemen, als de identiteit van het bedrijf aan één SaaS-account hangt of als herstelplannen bestaan op whiteboards, dan is dat register papierpijn bij de eerste echte stresssituatie.
Waarom risicoregisters falen
Risicoregisters zijn gemaakt voor beheersbaarheid: je kunt er categorieën, scores en acties aan hangen. Dat is geweldig om compliance-uitvoering te demonstreren, maar rampzalig als je wilt weten waar de organisatie écht kwetsbaar is. Inventarisaties richten zich op zichtbare dingen: servers, applicaties, contracten. De lijm tussen die dingen — API-koppelingen, CI/CD-pipelines, identity-flows, en vooral menselijk weten — komt er vaak bekaaid vanaf. Silo-eigenaarschap zorgt dat iedereen verantwoordelijk is voor ‘zijn’ component, niemand voor de keten.
Daarnaast geeft de checklistcultuur een vals gevoel van veiligheid. Als een controle toch ‘in scope’ is, krijgt het aandacht; als iets ongrijpbaar is, schuift het naar ‘later’. Spoiler: later is meestal na het incident.
De onzichtbare afhankelijkheden die wél knock‑out gaan
Niet alle afhankelijkheden zijn technisch. Tacit knowledge, de vergeten API-sleutel in een deployment-pipeline, de enige engineer die het legacy-systeem begrijpt, of de centrale identiteitstoken die alle SaaS-tools verbindt: allemaal even destructief. Een enkele wijziging bij een identity- of key-provider kan meerdere schijnbaar onafhankelijke systemen tegelijk uitschakelen. De busfactor is geen abstract begrip; het is pijnlijk concreet bij elk incident waar kennis verdwenen is met een vertrekkende collega.
Ook contractuele en operationele ontwerpen behoren tot de risicobronnen. Shared responsibility-modellen die niemand leest, monitoring die data tegenhoudt in plaats van doorgeeft, of back-ups die niet getest zijn: stuk voor stuk dependencies die in het risicoregister zelden het predicaat ‘kritisch’ krijgen, terwijl ze dat in de praktijk wel zijn.
Economische en contractuele bommen onder je architectuur
Leverancierscontracten focussen op uptimepercentages en responsetijden, niet op wat er gebeurt als de leverancier zijn API-keys roteert, zijn supportteam verandert of een cruciale integratie heel langzaam facturabel maakt. Exitstrategieën bestaan vaak uit een enkele regel in een SLA, maar een exit is geen juridische clausule: het is een technische en organisatorische oefening. Als die er niet is, heet het geen lock-in; het heet een tijdbom.
Verder onderschatten organisaties de impact van onduidelijke eigenaarschapscultuur. Wie betaalt voor de extra storage als een leverancier dataretentie opeist? Wie neemt de proactieve kosten voor integratie-upgrades? Die discussies worden te laat gevoerd, meestal tijdens een incident waarbij ‘nieuwe’ kosten plotseling levensbelangrijk blijken.
Detecteer het onzichtbare: praktische, onmiddellijke stappen
Begin met het tekenen van gegevens- en controlestromen, niet met het opsommen van assets. Volg waar identiteiten, sleutelmaterialen en autorisaties lopen. Vraag je team: welke processen vallen stil als deze API, deze identiteitsprovider of deze build-pipeline uitvalt? Gebruik die antwoorden als basis voor prioritering, niet de score op een generiek risicoformulier.
Voer opzettelijke verstoringen uit op gecontroleerde schaal. Niet omdat je van chaos houdt, maar omdat je wilt ontdekken wat er gebeurt als de sleutelvernieuwing faalt, als de CI-pipeline een fout introduceert of als de enige beheerder met vakantie is. Documenteer runbooks die bewezen werken, en laat die runbooks auditen door mensen die het systeem niet dagelijks bedienen. Contracteer en toets werkelijk overdraagbare bronnen: escrow voor code en configuratie, en zorg dat sleutelbeheer buiten één persoon of één leverancier wordt belegd. Key management is saai en technisch, maar het is ook precies waar je organisatie het snelst kwetsbaar wordt.
Tot slot: test herstel, niet alleen backup. Een back-up die we niet binnen geplande tijd kan terugzetten is geen mitigatie; het is een papieren geruststelling.
Wie moet het beslissen en wie betaalt ervoor?
Het antwoord is simpel en pijnlijk tegelijk: het bestuur moet het willen, de CTO moet het organiseren en de CISO moet het prioriteren. Maar verantwoordelijkheid mag niet verzanden in strategisch jargon. Bedrijfsprocessen hebben eigenaren die de impact van downtime voelen; die eigenaren moeten samen met IT de economische consequenties dragen. Dit vergt budget en sturing: resilience is geen technische hobby, het is productkwaliteit.
Zonder duidelijke governance blijft alles een ‘IT-probleem’. En geloof me, dat lost niets op als het hele bedrijf afhankelijk is van één ongedocumenteerde sleutel of één persoon die alles weet.
Wat is dan de echte IT-realiteit?
De echte IT-realiteit is dat je grootste cyberafhankelijkheid zelden een dreiging is die je kunt eisen in een checklist. Het is een weefsel van contracten, operationalisering, tacit knowledge en identiteitsstromen. Dat weefsel houdt je bedrijf draaiende — en het is precies wat breekt als je er niet op oefent. Risicoregisters geven comfort, maar comfort betaalt niet de rekeningen na een outage.
Praktische maatregelen zijn niet spectaculair: flowmapping, runbooktesten, vendor-escrow, multi‑owner key management en chaosoefeningen. Ze vragen geduld en budget, en ze vragen dat bestuur en techniek dezelfde taal spreken over wat ‘kritisch’ betekent. Het vereist ook dat je stopt met het definiëren van risico’s vanuit compliance en begint te denken in ketens en scenario’s.
Als je één ding vandaag meeneemt: een risicoregister zonder afhankelijkheidsmapping is een lijst met goede voornemens. Zorg dat je organisatie de dingen die echt alles platleggen expliciet vastlegt, test en belegt. Want als die onzichtbare afhankelijkheid faalt, merkt niet de auditor het eerst — maar de klant.