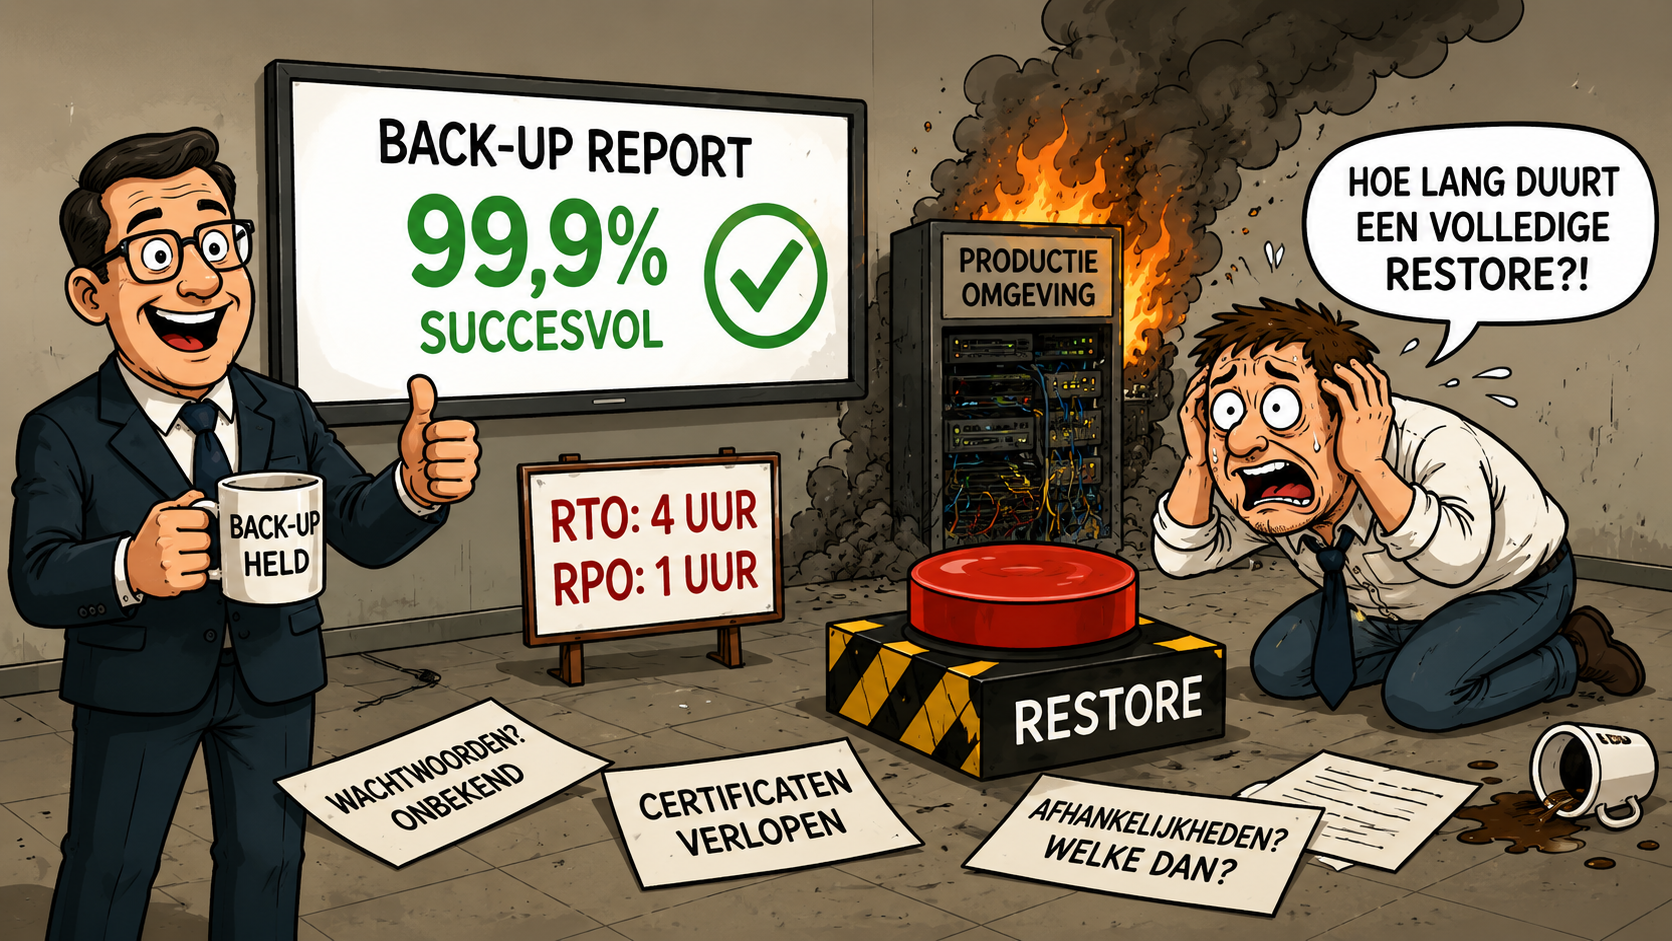
Een back-updashboard vol groene vinkjes is een van de prettigste vormen van schijnzekerheid die IT heeft voortgebracht. De jobs zijn geslaagd, replicatie is voltooid, de retentie klopt en ergens staat keurig 99,9 procent succes. Dat cijfer belandt vervolgens in een rapportage alsof daarmee ook iets is bewezen over bedrijfscontinuïteit. Alleen is de werkelijke vraag niet of de back-upsoftware vannacht tevreden was. De werkelijke vraag is hoeveel uur het duurt voordat een kritieke bedrijfsdienst weer werkt wanneer productie echt weg is.
Dat verschil lijkt klein zolang alles functioneert. Tijdens een storing blijkt het enorm. Een back-up zegt dat data is opgeslagen. Herstelbaarheid zegt dat de organisatie met die data, de juiste infrastructuur, accounts, certificaten, koppelingen, leveranciers en mensen weer kan functioneren. Het eerste is techniek. Het tweede is continuïteit. Toch worden die twee in veel organisaties nog steeds gemakzuchtig als hetzelfde behandeld.
Het groene vinkje bewijst vooral dat de back-upsoftware tevreden is
Een succesvolle back-up van een server is nog geen succesvolle herstelstrategie voor een bedrijfsproces. Een ERP-omgeving bestaat bijvoorbeeld niet uit één virtuele machine die na een restore vanzelf weer nuttig werk gaat doen. Er zijn databases, identitydiensten, DNS, certificaten, netwerkverbindingen, firewallregels, serviceaccounts en koppelingen met andere systemen nodig. Soms hangt daar ook nog een externe leverancier tussen die tijdens een crisis ineens een stuk belangrijker blijkt dan in het architectuurdiagram.
Wie alleen controleert of afzonderlijke componenten zijn opgeslagen, weet dus nog niet of de complete keten terug kan komen. Dat is het fundamentele probleem met back-uprapportages richting management. Ze presenteren een technische activiteit alsof daarmee een bedrijfsresultaat is gegarandeerd. Dat is comfortabel, meetbaar en vooral gevaarlijk eenvoudig.
Een bestuurder die tijdens een grote storing vraagt wanneer Finance weer betalingen kan uitvoeren, heeft weinig aan het antwoord dat alle databases succesvol zijn geback-upt. De relevante vraag is wanneer de dienst daadwerkelijk bruikbaar is. Precies daar houdt de klassieke back-up-KPI op en begint herstelbaarheid.
RTO en RPO zijn geen administratieve eigenschappen van een applicatie
Vrijwel iedere organisatie kent inmiddels de afkortingen RTO en RPO. De Recovery Time Objective bepaalt binnen welke tijd een dienst hersteld moet zijn. De Recovery Point Objective bepaalt hoeveel gegevensverlies acceptabel is. Het probleem zit meestal niet in de definities. Het probleem begint zodra iemand die waarden in een spreadsheet zet en de organisatie vervolgens doet alsof daarmee een herstelvermogen is ontstaan.
Een RTO van vier uur betekent niet dat vier uur ergens als gewenste waarde staat geregistreerd. Het betekent dat de complete dienst aantoonbaar binnen vier uur teruggebracht kan worden. Als de database drie uur nodig heeft om te herstellen, daarna blijkt dat een certificaat is verlopen, vervolgens een firewallregel ontbreekt en uiteindelijk niemand meer weet met welk serviceaccount een koppeling draait, dan is vier uur geen RTO. Het is een optimistische wens.
Voor RPO geldt precies hetzelfde. Als de business maximaal vijftien minuten dataverlies accepteert, terwijl in de praktijk alleen een herstelpunt van zes uur geleden bruikbaar blijkt, heeft de organisatie geen RPO van vijftien minuten. Zij heeft een document waarin vijftien minuten staat.
RTO en RPO zijn pas serieus zodra ze consequenties hebben voor architectuur, processen, contracten, budget en oefening. Tot dat moment zijn het keurige getallen met een verrassend beperkte relatie tot de werkelijkheid.
Eén storing kan meer leren dan jaren aan rapportages
Ik heb zelf gezien hoe hard dat verschil kan aankomen. Ruim veertien jaar geleden begaf de SAN-storage van een onderwijsinstelling het. In één keer was de volledige virtuele omgeving onbereikbaar. Financiën, salarisadministratie, bestanden en mail waren weg. De back-up stond bovendien op hetzelfde systeem en de tapes die als laatste redmiddel moesten dienen, bleken niet bruikbaar.
De organisatie lag uiteindelijk zeven dagen grotendeels stil. Een extern datarecoverybedrijf moest de schijven uitlezen en de virtuele machines kwamen stap voor stap terug. Het meest leerzame moment was niet de technische recovery zelf. Pas tijdens de storing ontstond de discussie over wat als eerste terug moest komen. Financiën en daarna salaris kregen prioriteit omdat leveranciers en medewerkers simpelweg betaald moesten worden.
Dat klinkt achteraf vanzelfsprekend. Het pijnlijke punt is juist dat zo’n herstelvolgorde vóór de storing vanzelfsprekend had moeten zijn.
Daar hoort ook een minder comfortabele constatering bij. Ik was zelf medeverantwoordelijk voor de architectuurkeuzes. Het excuus dat budget en middelen beperkt waren, was op dat moment niet verzonnen. Het was alleen ook geen herstelstrategie. Na zeven dagen stilstand bleken geld, aandacht en capaciteit ineens een stuk makkelijker beschikbaar. Kennelijk moet continuïteit soms eerst duur genoeg misgaan voordat een organisatie begrijpt wat zij eigenlijk waard is.
De les is hard maar simpel. Een back-up op dezelfde opslag is geen back-up, maar een kopie met een goede reputatie. En zelfs een goede, gescheiden back-up is nog geen bewezen herstelvermogen.
Ransomware heeft herstel definitief veranderd
Bij een klassieke hardwarestoring is het probleem meestal duidelijk: iets is kapot en moet worden vervangen of teruggezet. Bij ransomware is die luxe verdwenen. Een aanvaller kan langere tijd in een omgeving aanwezig zijn voordat encryptie zichtbaar wordt. In die periode kunnen beheeraccounts worden gestolen, snapshots worden verwijderd, retentie worden aangepast en back-upomgevingen worden verkend.
Daarom zijn immutable back-ups, gescheiden beheeraccounts en kopieën buiten het primaire productiedomein logisch en noodzakelijk. Alleen bewijzen ook die maatregelen nog niet dat een organisatie snel terug kan komen. Je kunt perfecte kopieën hebben van een omgeving die je voorlopig niet vertrouwt. Je kunt een onaantastbare repository hebben en toch ontdekken dat de enige beheerdersaccounts nodig zijn uit precies het identityplatform dat eerst hersteld moet worden.
Ransomware maakt daardoor zichtbaar dat recovery veel verder gaat dan opslag. Je moet weten welk herstelpunt betrouwbaar is, welke systemen schoon opnieuw opgebouwd moeten worden, welke afhankelijkheden nodig zijn en wie uiteindelijk beslist dat een omgeving veilig genoeg is om weer in productie te nemen.
Wie dat pas tijdens de aanval gaat uitzoeken, is niet aan het herstellen. Die organisatie is onder maximale druk haar herstelstrategie nog aan het ontwerpen.
Een bestand terugzetten is nuttig, maar het is geen hersteltest
Veel organisaties zeggen dat zij restores testen. In werkelijkheid wordt dan vaak een verwijderd bestand teruggezet, een mailbox hersteld of een database naar een testomgeving gekopieerd. Dat is verstandig en moet vooral blijven gebeuren. Alleen is het een componenttest, geen bewijs dat een kritieke bedrijfsdienst na een grote verstoring kan worden hersteld.
Een echte hersteltest begint bij een veel onaangenamere situatie. Productie is niet beschikbaar of niet meer te vertrouwen. Vanaf dat moment moet de organisatie zelfstandig de belangrijkste dienst opnieuw kunnen opbouwen. Dan komen de vragen naar boven die een dagelijkse back-upjob zorgvuldig voor je verborgen houdt.
Kunnen beheerders nog inloggen wanneer het primaire identityplatform niet beschikbaar is? Zijn noodaccounts en credentials onafhankelijk van de getroffen omgeving beschikbaar? Welke systemen moeten eerst worden teruggebracht? Welke certificaten, koppelingen en netwerkcomponenten zijn nodig? Wie kan een externe leverancier bellen wanneer mail en Teams niet functioneren? Wie heeft de bevoegdheid om herstelprioriteiten te wijzigen wanneer de oorspronkelijke planning niet haalbaar blijkt?
Dat soort vragen zijn lastig te automatiseren in een dashboard. Misschien verklaart dat waarom organisaties liever rapporteren over het percentage succesvolle back-upjobs. Een groen percentage voelt een stuk vriendelijker dan de ontdekking dat niemand het wachtwoord van het break-glass-account kent.
Herstel begint bij bedrijfsdiensten, niet bij virtuele machines
Een veelgemaakte fout is dat recoveryplannen worden opgebouwd vanuit infrastructuur. Server A moet eerst, daarna database B en vervolgens applicatieserver C. Technisch is dat logisch. Bedrijfsmatig zegt het weinig.
De organisatie heeft namelijk geen behoefte aan server A. Zij wil salarissen verwerken, klanten bedienen, orders uitleveren of facturen versturen. Dat betekent dat herstelplanning moet beginnen bij de minimale bedrijfsdienst die weer beschikbaar moet zijn. Pas daarna bepaal je welke technische componenten daarvoor nodig zijn.
Neem salarisbetaling. Daarvoor kunnen meerdere applicaties nodig zijn, maar ook gebruikersaccounts, bankkoppelingen, netwerktoegang, gegevensbestanden en specifieke medewerkers. Misschien blijkt tijdens een oefening zelfs dat het volledige HR-platform helemaal niet als eerste nodig is en dat een beperkte noodprocedure voldoende is om salarissen op tijd te betalen.
Dat is een belangrijk onderscheid. Techniek wil meestal alles terug. Continuïteit wil eerst datgene terug waarmee de organisatie weer kan functioneren.
Wie dat verschil begrijpt, kan tijdens een crisis veel gerichter herstellen. Wie het niet begrijpt, krijgt twintig technische teams die allemaal uitstekend werk leveren aan systemen die volgens hen de hoogste prioriteit hebben.
Het bestuur hoeft geen back-upexpert te zijn
Het bestuur hoeft niet te weten hoe snapshots, repositories of replicatietaken precies werken. Dat is operationele techniek. Maar het bestuur moet wel begrijpen welk bedrijfsrisico wordt geaccepteerd wanneer een cruciale dienst een dag, drie dagen of een week niet beschikbaar is.
Daarmee zijn RTO en RPO uiteindelijk bestuurlijke keuzes. Herstel binnen vier uur vraagt een andere architectuur en meestal een ander prijskaartje dan herstel binnen twee dagen. Misschien zijn extra capaciteit, redundantie, automatisering, standby-omgevingen of strengere leveranciersafspraken nodig. Dat geld wordt niet uitgegeven omdat IT graag mooiere techniek wil, maar omdat de organisatie een bepaalde hersteltijd noodzakelijk vindt.
Dat besluit mag dus niet stilzwijgend door een infrastructuurteam of leverancier worden genomen. Als de business vier uur eist maar slechts wil betalen voor een architectuur die twee dagen herstel realistisch maakt, bestaat er geen technisch probleem. Er bestaat een bestuurlijke inconsistentie.
Daarom is de vraag “hebben we back-ups?” voor bestuurders eigenlijk nauwelijks interessant. De veel betere vraag is: wanneer hebben we voor het laatst bewezen dat onze belangrijkste bedrijfsdiensten binnen de afgesproken tijd kunnen worden hersteld?
Die vraag produceert meestal minder groene vinkjes en betere gesprekken.
Stop met back-upsucces rapporteren als bewijs van weerbaarheid
Back-upmonitoring blijft belangrijk. Een mislukte job moet worden opgelost, opslagcapaciteit moet worden bewaakt en replicatie moet functioneren. Alleen hoort dat bij operationeel beheer. Het vertelt bestuur en directie nauwelijks iets over de werkelijke digitale weerbaarheid van de organisatie.
Veel interessanter is of de kritieke diensten een actuele herstelprocedure hebben, wanneer die voor het laatst is getest en hoe lang het herstel toen werkelijk duurde. Het verschil tussen afgesproken en gemeten hersteltijd vertelt aanzienlijk meer dan een percentage succesvolle back-ups.
Een hersteltest laat bovendien zien waar kennis werkelijk zit. Misschien blijkt een complete procedure alleen te werken omdat één ervaren beheerder precies weet welke drie stappen niet in de documentatie staan. Op papier bestaat er dan een professioneel proces. In werkelijkheid bestaat de continuïteitsstrategie uit hopen dat die medewerker geen vakantie heeft.
Dat is niet uitzonderlijk. Het is alleen zelden zichtbaar zolang niemand de omgeving echt probeert terug te bouwen.
Een continuïteitsdashboard dat altijd groen is, zou daarom eerder wantrouwen moeten oproepen dan trots. Wie serieus test, vindt problemen. Dat is geen mislukking. Dat is waarvoor de test bestaat.
Een mislukte hersteltest is beter dan een succesvolle illusie
Hersteltests kosten tijd. Ze vragen capaciteit van beheerders, applicatie-eigenaren, securityspecialisten, leveranciers en soms de business. Documentatie blijkt verouderd, scripts falen en aannames blijken niet te kloppen. Daardoor is het verleidelijk om oefeningen klein te houden zodat het eindrapport beheersbaar blijft.
Dat is precies de verkeerde reflex.
Wanneer een dienst tijdens een test acht uur nodig heeft terwijl een RTO van vier uur is afgesproken, heeft de test uitstekend gewerkt. De organisatie beschikt eindelijk over een feit in plaats van een aanname. Vervolgens kan zij investeren in betere automatisering, architectuur of procedures. Zij kan de afhankelijkheid van één specialist verminderen. Of misschien blijkt dat vier uur economisch helemaal niet gerechtvaardigd is en wordt de RTO bewust aangepast.
Al die uitkomsten zijn volwassen. Wat niet volwassen is, is jarenlang een RTO van vier uur rapporteren zonder ooit geprobeerd te hebben de dienst binnen vier uur te herstellen.
Bedrijfscontinuïteit ontstaat niet doordat een document overtuigend genoeg klinkt. Het ontstaat doordat een organisatie vooraf moeilijke keuzes maakt en vervolgens controleert of die keuzes onder druk werkelijk standhouden.
Wat is dan de echte IT-realiteit?
Een back-up is geen eindproduct. Het is grondstof voor herstel. Zolang je alleen kunt aantonen dat data succesvol wordt opgeslagen, weet je nog niet of je organisatie een grote technische storing, ransomwareaanval of menselijke fout daadwerkelijk kan overleven.
De werkelijke maatstaf is niet hoeveel back-upjobs groen zijn. De werkelijke maatstaf is hoeveel kritieke bedrijfsdiensten aantoonbaar binnen de afgesproken hersteltijd kunnen worden teruggebracht en hoeveel gegevens daarbij werkelijk verloren gaan.
Wie dat nooit volledig heeft getest, heeft geen zekerheid. Die heeft een verwachting. Misschien een uitstekend gedocumenteerde verwachting met SLA’s, dashboards en keurige rapportages, maar nog steeds een verwachting.
En juist daar zit de ongemakkelijke IT-realiteit. We besteden veel tijd aan aantonen dat onze back-ups werken, terwijl de organisatie maar één ding nodig heeft wanneer alles misgaat: bewijs dat wij terug kunnen komen.
Je back-up is pas iets waard op de dag dat je bewezen hebt dat je ermee kunt herstellen.
Geef een reactie